爬取某顺的业绩预告小程序,帮你避坑
某顺的业绩预告网址:https://data.10jqka.com.cn/financial/yjyg/
程序适配Windows PC平台,装个Chrome浏览器。
程序可以留存,季报、中报、年报的时候,都可以拿来用一下,不一定能帮你挣钱,起码能帮你避坑。
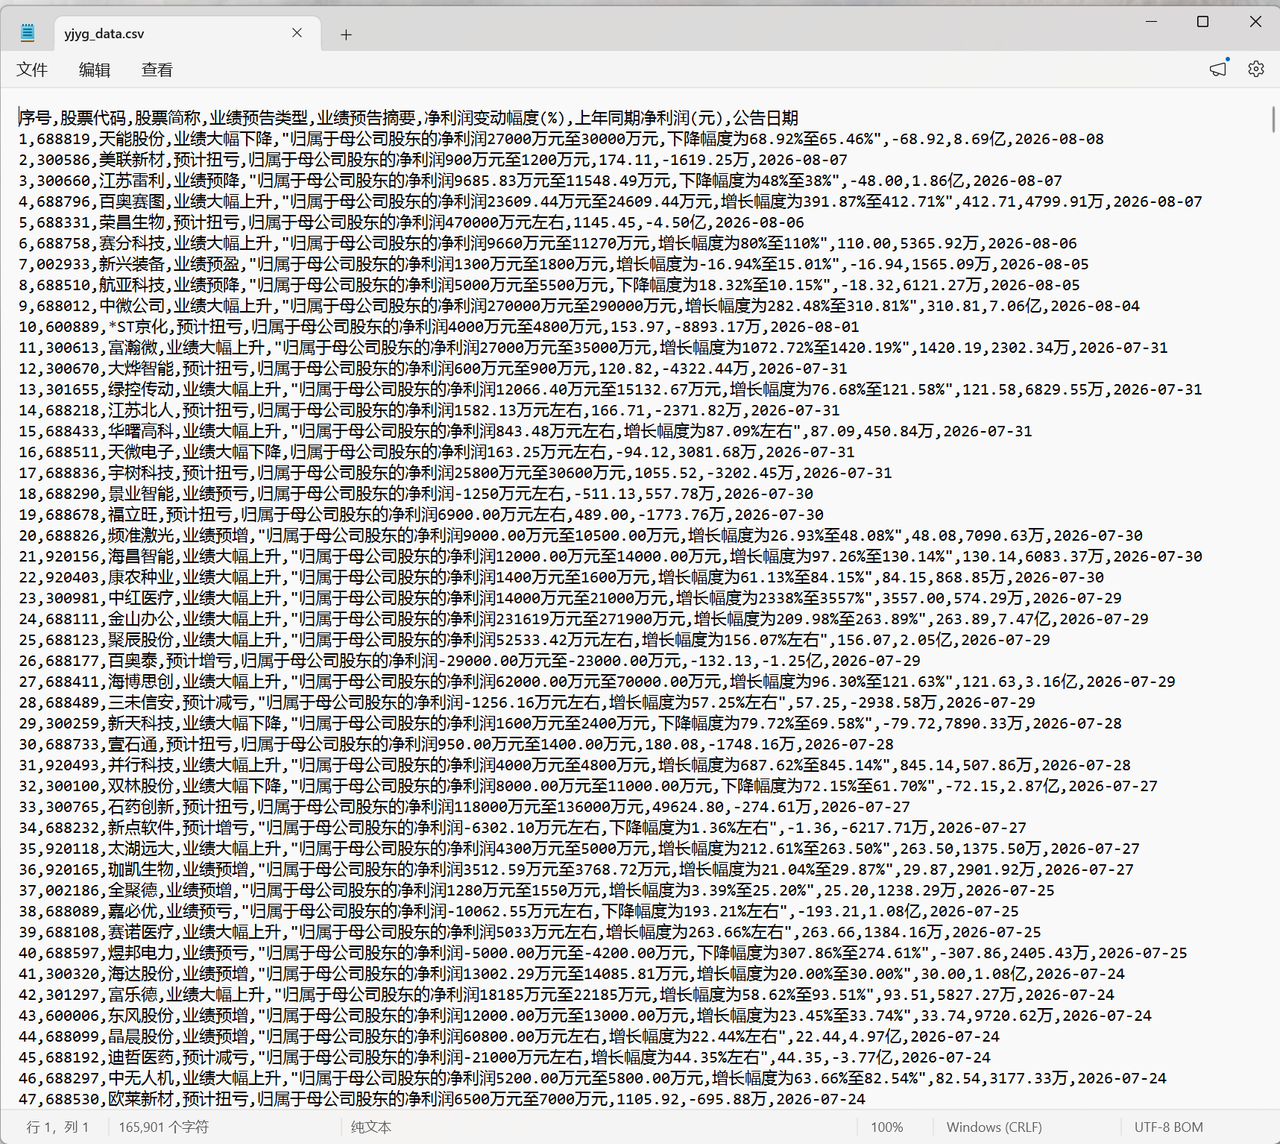
要爬取的总页数,手动填写,存储为CSV格式文件。爬取的时候,注意频率,避免被封IP。
数据在手,折腾我有
[Python] 纯文本查看 复制代码
# !/usr/bin/env python
# coding=utf-8
import random
import time
import pandas as pd
from DrissionPage import ChromiumPage, ChromiumOptions
class THSPerformanceForecast:
PAGE_URL = "https://data.10jqka.com.cn/financial/yjyg/"
def __init__(self):
co = ChromiumOptions()
co.set_argument('--no-sandbox')
co.auto_port()
self.browser = ChromiumPage(co)
self.browser.get(self.PAGE_URL)
self.browser.ele('css:table.m-table tbody tr', timeout=15)
print("[✓] 页面加载完成,表格已渲染")
@staticmethod
def parse_numeric(text: str) -> float | None:
"""将网页文本安全转为浮点数"""
s = text.strip()
if not s or s == '-':
return None
s = s.replace('-', '-').replace('–', '-').replace('—', '-').replace('−', '-')
s = s.replace(',', '').replace('\xa0', '')
try:
return float(s)
except ValueError:
return None
def fetch_page(self, page: int) -> list[dict]:
"""从当前页面DOM提取表格数据"""
if page > 1:
next_btn = self.browser.ele(f'css:a.changePage[page="{page}"]', timeout=15)
if not next_btn:
next_btn = self.browser.ele('text:下一页', timeout=15)
if next_btn:
next_btn.click()
try:
self.browser.ele('css:.page-loading', timeout=3).wait.hidden(timeout=10)
except Exception:
pass
time.sleep(2)
self.browser.ele(f'css:a.cur[text()="{page}"]', timeout=10)
else:
print(f"[✗] 第{page}页未找到翻页按钮")
return []
# 提取表格数据
rows = self.browser.eles('css:table.m-table tbody tr')
if not rows:
print(f"[✗] 第{page}页表格无数据行")
return []
records = []
for row in rows:
cols = row.eles('tag:td')
if len(cols) < 8:
continue
record = {
'序号': int(cols[0].text.strip()) if cols[0].text.strip().isdigit() else None,
'股票代码': cols[1].text.strip(),
'股票简称': cols[2].text.strip(),
'业绩预告类型': cols[3].text.strip(),
'业绩预告摘要': cols[4].text.strip(),
'净利润变动幅度(%)': self.parse_numeric(cols[5].text),
'上年同期净利润(元)': cols[6].text.strip(),
'公告日期': cols[7].text.strip(),
}
records.append(record)
print(f" 第{page}页: 提取{len(records)}条记录")
return records
def fetch_all(self, total_pages: int = 38) -> pd.DataFrame:
all_records = []
for page in range(1, total_pages + 1):
print(f"正在获取第{page}/{total_pages}页...")
try:
records = self.fetch_page(page)
except Exception as e:
print(f"[!] 第{page}页异常: {e}")
records = []
if records:
all_records.extend(records)
else:
print(f"[!] 第{page}页无数据,停止采集")
break
time.sleep(random.uniform(2, 5))
df = pd.DataFrame(all_records)
print(f"\n[✓] 共获取{len(df)}条记录")
return df
if __name__ == '__main__':
scraper = THSPerformanceForecast()
df = scraper.fetch_all(total_pages=38)
if not df.empty:
df.to_csv('yjyg_data.csv', index=False, encoding='utf-8-sig')
print("[✓] 已保存到 yjyg_data.csv")
else:
print("[✗] 未获取到任何数据") | 
 [复制链接]
 发表于 2026-8-10 04:49
 |
发表于 2026-8-10 05:09



